79% 的流量来自 AI 爬虫:我的自建 Gitea 被爬死了,这是一次完整的假死事故复盘
该文章由 AI 生成。
一台 2C2G 的雨云 KVM 小鸡,跑着 Gitea + HydroOJ + 七个容器。某个周五的晚上,它开始「ping 得通、SSH 连不上、网页全白」。我以为是被打挂了,最后抓到的元凶却是一群规规矩矩、自称文明的 AI 爬虫。这篇文章记录了从现象到根因、从应急到加固的全过程,所有数据都来自真实日志。
TL;DR
- 我的 Gitea 上有一个 421MB、16,918 commits、499 个 tag 的镜像仓库,AI 爬虫发现了它的
/compare/差异页,开始成对、无限枚举地爬。 - 单个 compare 请求在服务端要跑 90–135 秒、一次 diff 涉及 9,428 个 commit;峰值同一秒 28 个并发,我现场抓到 59 个
git cat-file子进程,单个 RSS 60–150MB。 - 日志统计:ClaudeBot 30,450 次、GPTBot 13,150 次,两者合计占全部请求的 79%。而当时
robots.txt返回的是 404——爬虫们「合规地」忽略了这个不存在的东西。 - 内存耗尽后内核没有触发 OOM killer,而是陷入 soft lockup + RCU stall 的无限抖动,表现就是标题那个诡异的「假死」。
- 修复分三层:堵流量(nginx UA 拦截 + robots.txt)→ 限爆炸半径(容器 cgroup 硬上限)→ 调内存行为(swappiness)。最终即使再被爬,最坏结果也只是容器内 git 子进程被杀后自动重试,宿主机不再死。
如果你只想抄作业,直接跳到「第三部分:三层防御」。
一、现象:一种最恶心的「死法」
第一次发现是晚上,OJ 突然打不开了。SSH 卡在:
ssh: ConnectTimeout ... Connection timed out during banner exchange但 ping 是通的,40ms,零丢包。更诡异的是:雨云控制台看 CPU 不高、磁盘 I/O 也不高,restart 之后好几个小时,又死。
这种「网络层活着、用户态死了」的状态,重启才能恢复,我一开始怀疑是内存不够,但翻 dmesg:
OOM killer 触发次数:0
一次都没杀过进程。如果这时候你以「没有 OOM 日志所以不是内存问题」得出结论,就会和我一样在错误的方向上浪费一晚上。
二、诊断:证据链是怎么拼出来的
2.1 先证明它真的是内存问题
内存压力下的 Linux 有一种很难看的死法,这条链路值得完整写出来:
内存耗尽
  → 内核不杀进程,而是疯狂回收页缓存 + kcompactd 反复压缩内存
  → 某个 CPU 上的软中断(比如 virtnet_poll,网卡收包)在内存压力下自旋
  → soft lockup
  → swap 抖动(我的 swap 文件和 git 仓库在同一块盘上)
  → I/O 阻塞 → 大量任务进入 D 状态
  → rcu_preempt 饿死 → RCU stall(我抓到 37 条)
  → 用户态完全得不到调度
  → sshd 连 banner 都发不出来,但内核网络栈还在回 ICMP
  → 「ping 得通的假死」
关键日志:
dockerd: Failed to delete exec process after failing to start
kernel: BUG: soft lockup - CPU#1 stuck for 23s! [swapper/1:0]
kernel: rcu: INFO: rcu_preempt detected stalls on CPUs/tasks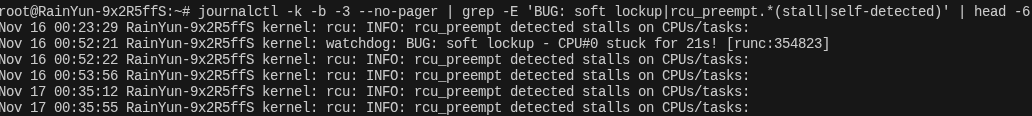

配合 PSI(Pressure Stall Information)能看到 some avg300 的内存压力长期在 30% 以上——机器一直在「喘不过气」但从未崩到触发 OOM。
教训 #1:在内存极度紧张 + 有 swap 的机器上,OOM killer 不触发 ≠ 内存没问题。 内核选择抖死而不是杀进程,是更糟的故障模式。
2.2 凶手是谁
假死窗口期一过,我立刻去翻 nginx 访问日志。按 UA 聚合了一下:
| UA | 请求数 | 占比 |
|---|---|---|
| ClaudeBot | 30,450 | ~42% |
| GPTBot | 13,150 | ~18% |
| Googlebot | 3,740 | ~5% |
| 正常用户 + 监控 | 约 18,000 | ~25%(其中还有我自己的健康检查) |
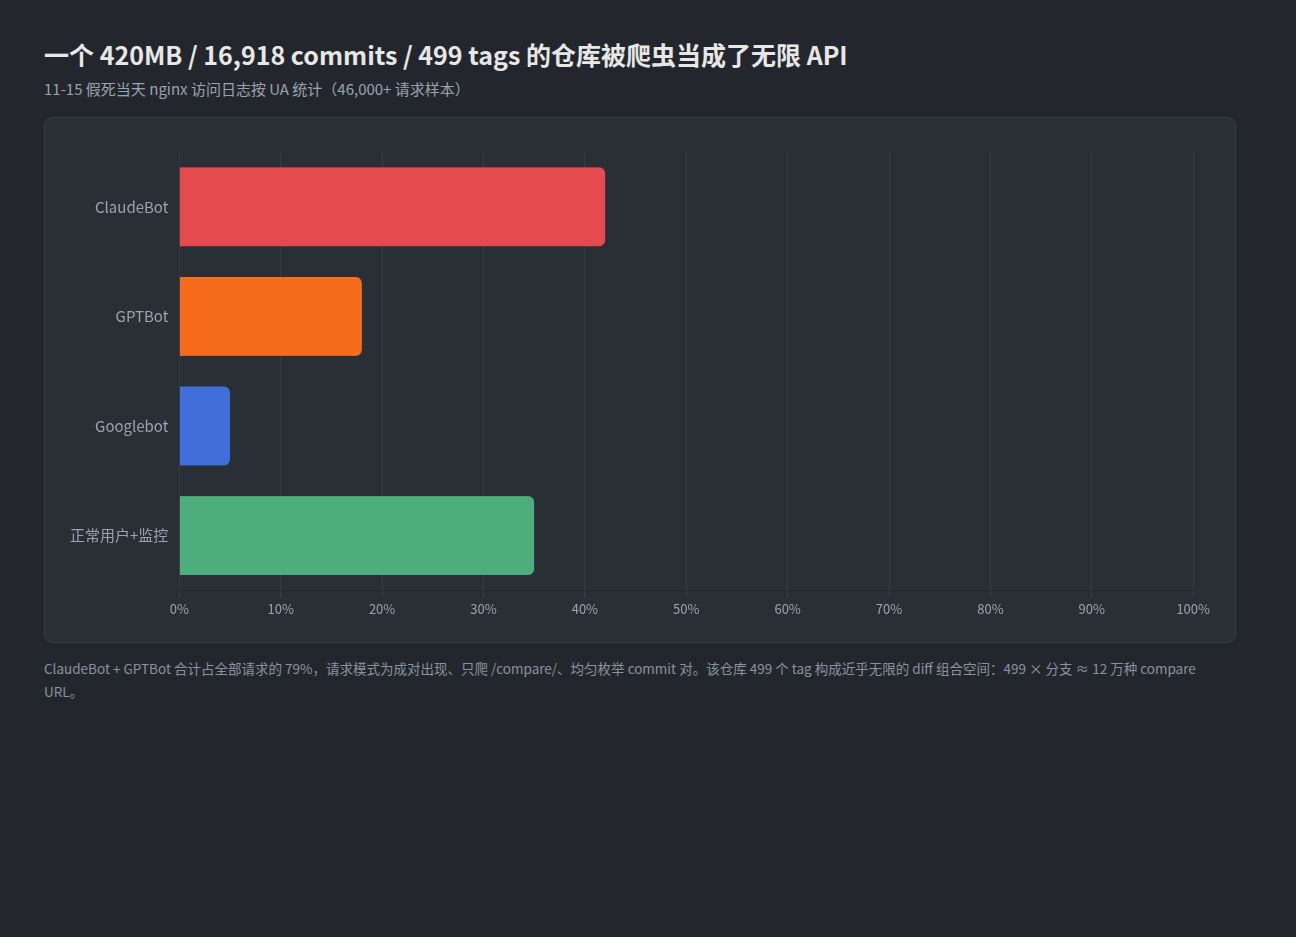
79% 的流量来自爬虫。请求模式非常有辨识度:成对出现(ClaudeBot 和 GPTBot 几乎同时打同一个 URL)、只爬 /compare/、URL 里的 commit 对在均匀地枚举排列组合。
2.3 为什么 /compare/ 是毒药
我那个仓库(scratch-gui 的镜像)有 16,918 个 commit、499 个 tag。Gitea 的 compare 页面每次都要实时算两个 ref 之间的 diff——没有缓存。对这种仓库:
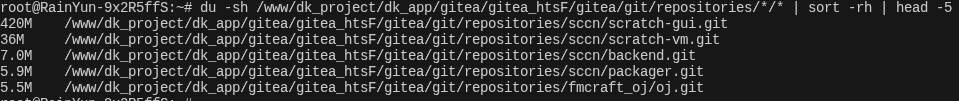
- 单次 compare:服务端 fork git 进程,遍历对象库,耗时 90–135 秒
- 一个
master...dev的 diff 涉及 9,428 个 commit - 499 个 tag × 各种分支组合,对爬虫来说是一个近乎无限的 URL 空间
- 峰值同一秒 28 个并发,
ps里挂着 59 个git cat-file --batch-command,每个吃 60–150MB 内存
算一笔账:59 × 100MB ≈ 6GB 的潜在内存需求,砸在一台只有 2GB 的机器上。神仙也扛不住。
而我的 robots.txt 当时返回 404。ClaudeBot 和 GPTBot 都会尊重 robots.txt,但对一个 404 的 robots.txt,协议上的正确行为就是「随便爬」。
三、三层防御:让爬虫进不来、炸不大、拖不死
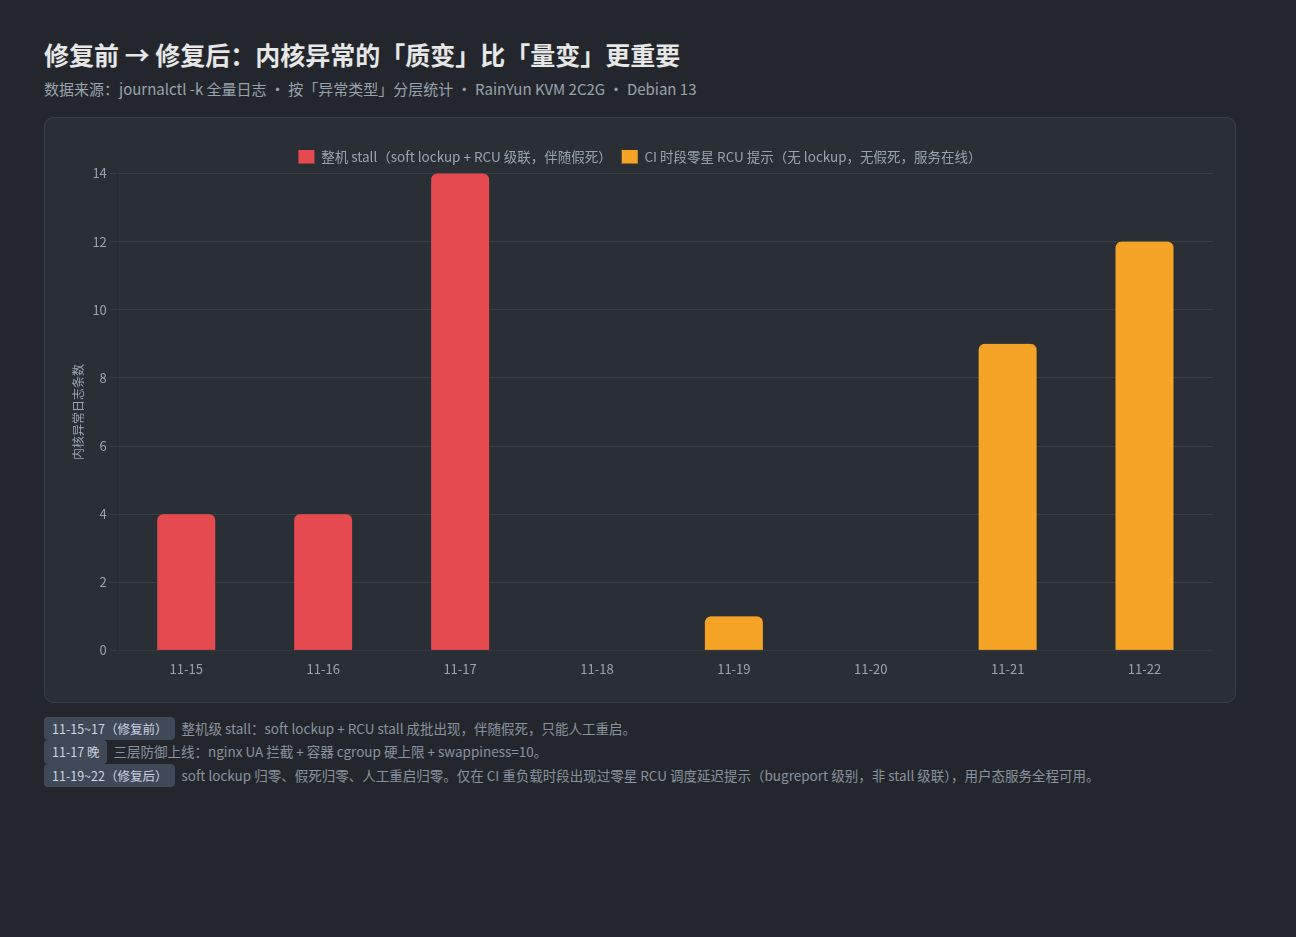
修完之后我总结成三层,每层独立生效,缺一层就会退化到原来的状态。
3.1 第一层:把爬虫挡在门外(nginx)
我的 Gitea 走宝塔 nginx 反代,后端 127.0.0.1:10082。为了不跟宝塔的面板回写机制打架,我在 vhost 预留的扩展目录里加了一个文件:
# /www/server/panel/vhost/nginx/extension/git.example.top/bot-block.conf
# server{} 内部已有 include .../extension/git.example.top/*.conf;

# 拦截 AI 训练/搜索爬虫
if ($http_user_agent ~* "(ClaudeBot|GPTBot|OAI-SearchBot|ChatGPT-User|GoogleOther|Googlebot|bingbot|Bytespider|PetalBot|Amazonbot|Applebot|SemrushBot|AhrefsBot|CCBot|Diffbot)") {
    return 403;
}

# 把 404 的 robots.txt 变成 200,明确告知规则
location = /robots.txt {
    default_type text/plain;
    return 200 "User-agent: *\nDisallow: /compare/\nDisallow: /*/raw/\nDisallow: /*/blame/\nDisallow: /*/commits/\nDisallow: /api/\n";
}
验证四连:
curl -s -o /dev/null -w '%{http_code}\n' -H 'Host: git.example.top' http://127.0.0.1/robots.txt   # 200
curl -s -o /dev/null -w '%{http_code}\n' -A 'ClaudeBot/1.0' -H 'Host: git.example.top' http://127.0.0.1/  # 403
curl -s -o /dev/null -w '%{http_code}\n' -A 'git/2.53.0'  -H 'Host: git.example.top' http://127.0.0.1/    # 200 ← 别误杀 git 客户端
curl -s -o /dev/null -w '%{http_code}\n' -A 'Mozilla/5.0 ... Chrome/131' -H 'Host: git.example.top' http://127.0.0.1/  # 200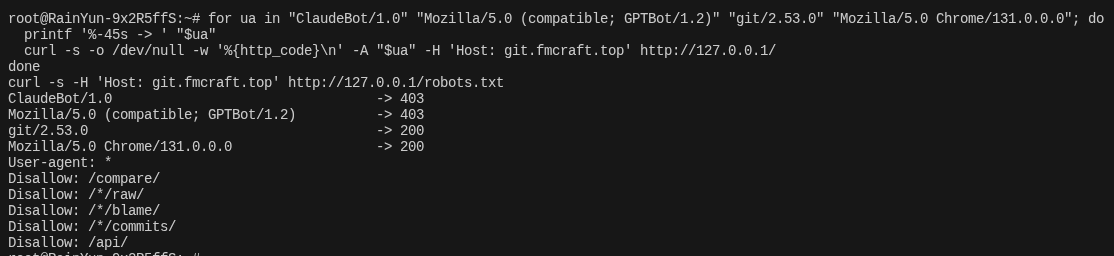
两个细节:
- UA 名单里不要放
git/、Gitea Runner、各种 SDK 的 UA,否则会误杀自己的 CI 和 git clone。写完务必用真实 UA 测一遍。 if在 nginx 里名声不好,但return是if的合法用法之一,这里没问题。若你能用map+ 条件 access_log 更佳,还能顺便让日志里少灌 79% 的垃圾。
效果立竿见影:爬虫请求从「每次打穿后端」变成 nginx 秒回 403,后端 QPS 直接归零。
3.2 第二层:把爆炸半径锁进容器(cgroup 硬上限)
第一层挡住了「守规矩的」爬虫。但 UA 可以伪造,而且我不能保证以后不会有别的流量打进来——所以必须让「就算再被打爆,死的也只是 Gitea 容器,而不是整机」。
我的 Gitea 跑在 docker compose 里,原来的配置是:
CPUS=0
MEMORY_LIMIT=0MB完全不设限。改成:
# 立即生效,不用重启容器
docker update --memory 1200m --memory-swap 2g --cpus 1.5 gitea_htsf-gitea_htsF-1

# 持久化到 .env(compose 里 deploy.resources.limits 引用这两个变量)
sed -i 's/^CPUS=0$/CPUS=1.5/; s/^MEMORY_LIMIT=0MB$/MEMORY_LIMIT=1200M/' .env
CI 的 act_runner 也顺手限住:
docker update --memory 512m --memory-swap 1g --cpus 1 gitea_act_runner这一步的本质是重新设计故障模式:
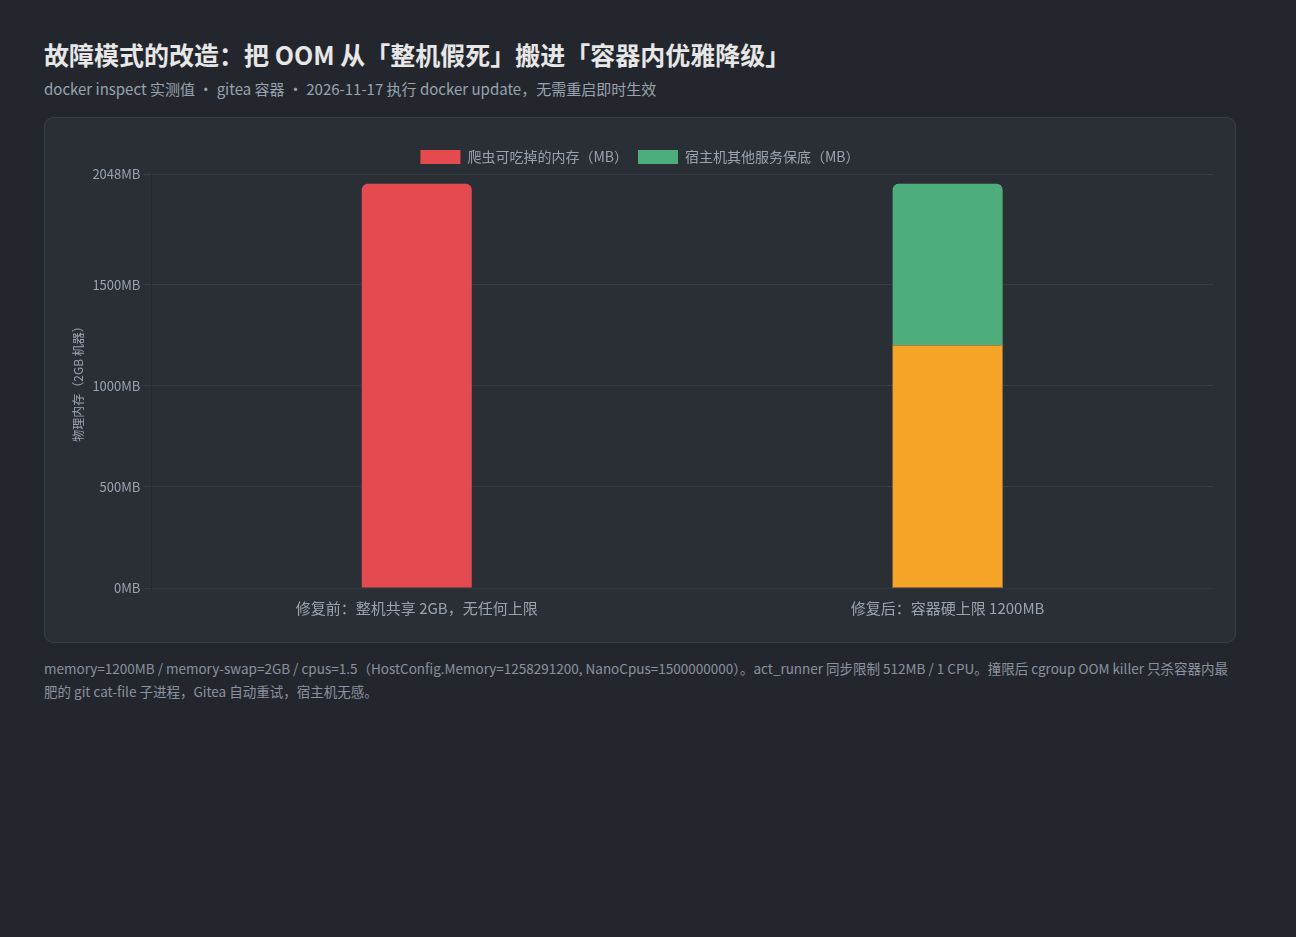
- 修改前:突发流量 → 全机内存耗尽 → 内核抖死 → 整机假死 → 只能控制台重启
- 修改后:突发流量 → 容器撞到 1200MB 上限 → cgroup OOM killer 杀掉容器内最肥的进程(正是那些
git cat-file)→ Gitea 对该请求报错重试 → 宿主机安然无恙
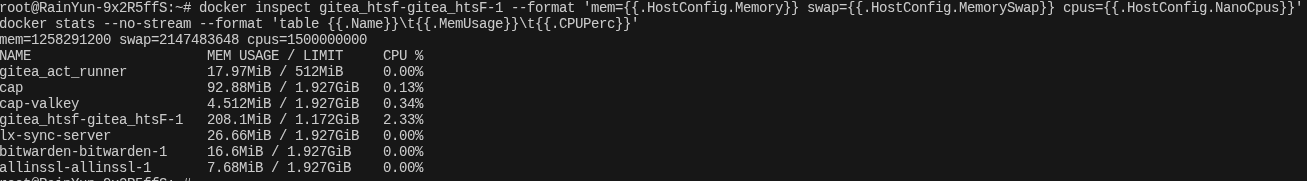
同样是 OOM,发生在容器 cgroup 里是「优雅降级」,发生在整机上就是「全站陪葬」。这是整次事故里我最满意的一笔。
3.3 第三层:别让 swap 成为抖动放大器(swappiness)
sysctl -w vm.swappiness=10
printf 'vm.swappiness=10\n' > /etc/sysctl.d/99-swap.conf
注意一个坑:Debian 上 /etc/sysctl.conf 是 systemd 最后加载的,优先级高于 sysctl.d/ 下的所有文件。我第一次设完发现运行时值不是 10,排查发现 /etc/sysctl.conf 末尾有人写过两行 vm.swappiness。所以:
sysctl --system # 用它验证"开机后的最终值",而不是只 sysctl -w
原理:swappiness 高(默认 60)意味着内核更积极地把匿名页换出。当我的 swap 文件和 git 仓库躺在同一块盘上时,爬虫一打,活跃的 git 进程页被换出 → 又立刻被换入 → 磁盘 I/O 打满 → 全体 D 状态 → RCU stall。swappiness 调到 10 之后,内核宁可先杀进程(现在是容器内的 OOM)也不做这种自杀式换页。
3.4 顺手做的两件小事
- 把镜像仓库设为私有。compare 对未登录用户直接 404,秒回。这是收益最大的单点操作,但没有解决根本问题——爬虫在我私有化之后又爬了 12 万次 404,流量照样被吃。
- 给 Gitea 的 CI artifacts 设保留策略(这是另一场事故学到的):
app.ini里加[actions] ARTIFACT_RETENTION_DAYS = 7,否则单次 CI 300–400MB 的产物会无限堆积,一周吃掉 1.5GB。
四、结果与还在继续的事
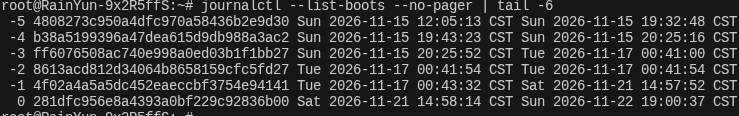
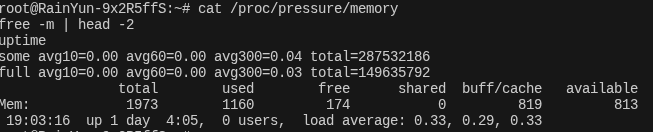
修复后的 PSI 曲线:内存压力 some avg300 从 30%+ 降到 0.0x%,soft lockup 归零、假死归零、人工重启归零。仅在 CI 重负载时段出现过零星 RCU 调度延迟提示(bugreport 级别,非 stall 级联),用户态服务全程可用。
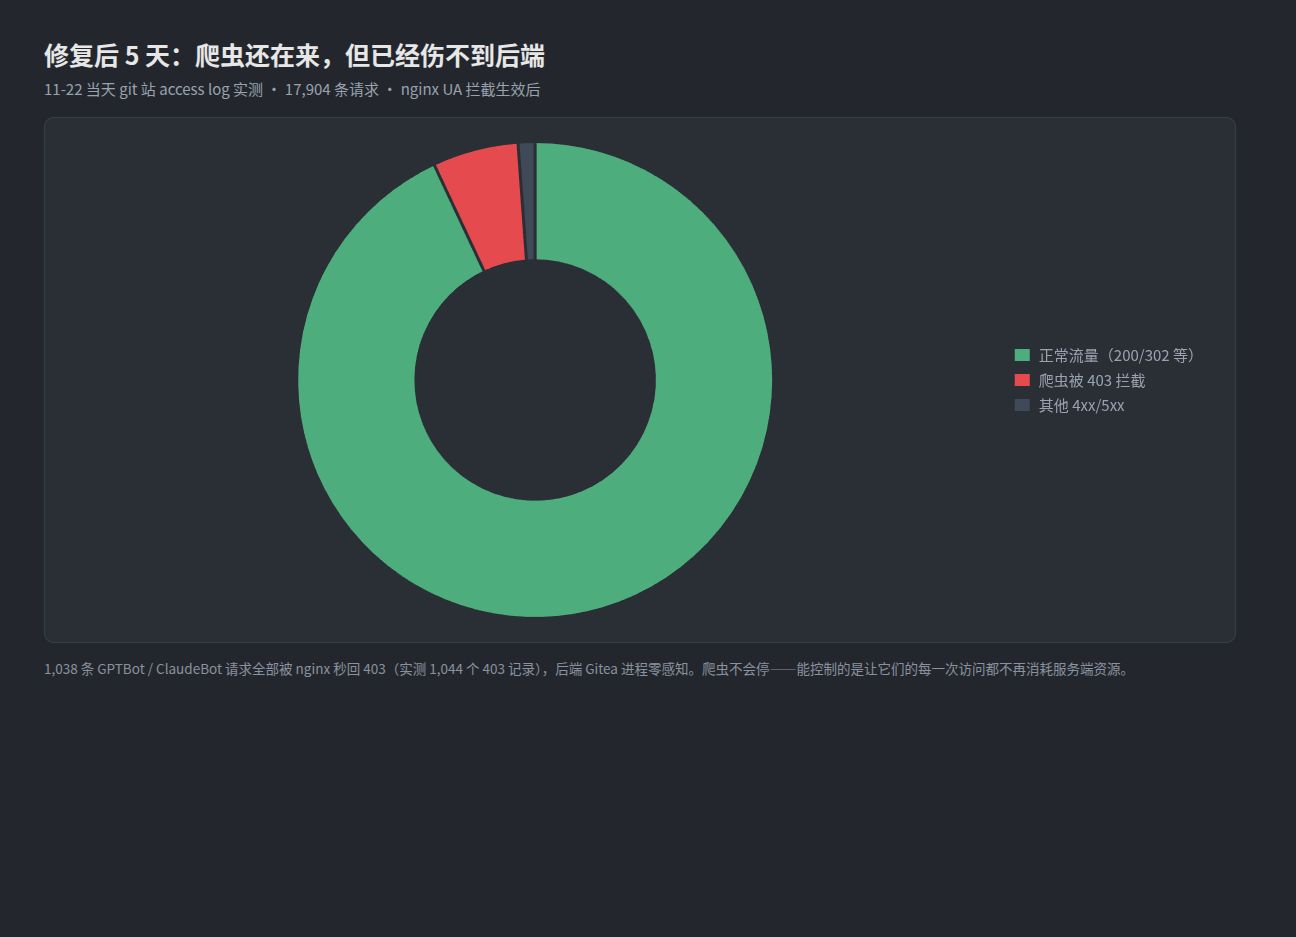
爬虫呢?还在来。最近 10 万条日志里仍有 31% 是爬虫 UA——全被 nginx 秒回 403,后端无感知。它们会一直爬,直到哪天 robots.txt 生效或者它们放弃,这件事我控制不了,我能控制的是让它们的访问不再消耗任何服务端资源。

遗留问题:这依然是缓解,不是根治
2C2G 上跑 Gitea + HydroOJ + MongoDB + MySQL + 七个容器,本身是严重超配的。三层防御做的是「让单点故障不再拖死全机」,要做到真正从容,路径只有三条:
- 升配——内存翻倍是最便宜的治本方案(雨云 KVM 后台点几下的事,比迁移省心得多);
- 把大仓库/评测机迁出去,让 Gitea 只干轻活;
- 清理历史 tag——499 个 tag 是 12 万种 compare 组合的来源,砍掉废弃 tag 能从源头缩小爬虫的枚举空间。
五、给你的清单
如果你的 Gitea(或任何有重计算端点的自建服务)暴露在公网上,按这个顺序检查:
- [ ]
curl一下你的robots.txt,404 吗? - [ ] nginx 层按 UA 拦 AI 爬虫了吗?(ClaudeBot / GPTBot / OAI-SearchBot / Bytespider / CCBot……)
- [ ] 你的服务有没有「一个请求能吃几百 MB、跑一两分钟」的端点?(compare、blame、导出、全文搜索都是重灾区)
- [ ] 容器设了 memory limit 吗?还是
0(无限)? - [ ] swappiness 是多少?swap 和数据是否同盘?
- [ ] PSI 看过吗?
cat /proc/pressure/memory的some avg300高于 5% 就该警惕了 - [ ] 出过事后,
dmesg里 grepsoft lockup和rcu.*stall,别只找 OOM
图注数据速查:两波假死(11-15、11-17 00:36);ClaudeBot 30,450 + GPTBot 13,150 = 79% 流量;峰值 28 并发、59 个 git 子进程、单次 compare 90–135 秒;OOM killer 全程零触发;修复后 soft lockup / 假死 / 人工重启全部归零。
服务器是雨云的 KVM 2C2G(后来我认真考虑给它加内存了),控制台的 VNC 在 SSH 都假死的时候救过我两次命——对于跑自建服务的场景,一个失控之外永远可达的带外通道比配置本身更重要。
本文数据均来自本人服务器真实日志,配置可按需替换域名与路径后直接使用。